09 luglio 2007

Presentazione Oracle 11g

Mercoledì 11 verrà presentata la prossima release di Oracle Database, la 11g.
Nel frattempo leggiamo qualche new feature, anche se penso che l'elenco indicato nell'intervista sia molto incompleto.
Io ho come la sensazione che ci sarà una grossa novità sulla gestione dell'undo... seguendo il ragionamento dei wandering logs di Reiserfs, immagino che sia applicabile il concetto anche all'undo... il tablespace di UNDO potrebbe addirittura sparire, lasciando il posto a una gestione dei blocchi completamente all'interno del proprio tablespace. Staremo a vedere.

25 giugno 2007

Falcon alpha: vediamo se funziona

Installato Ubuntu server 64 bit, spacchettiamo mysql 6 alpha e configuriamo i sorgenti:
root@ubu642:~# ./configure --with-plugins=all
seguito da un make e make install. Consiglio di utilizzare --prefix=/usr/local/mysql per "inscatolare" la versione alpha di mysql in una sua directory particolare, altrimenti tutto va in /usr/local. Copiate la vostra versione preferita di my.cnf in /etc, create il database "starter" con mysql_install_db, cambiate i permessi del database con chmod, e impostate la password di root con mysqladmin; create poi un utente che ha tutti i grant sul database di test predisposto.

CREATE TABLE f (
fid int(11) NOT NULL,
descr varchar(32) DEFAULT NULL,
PRIMARY KEY (fid)
) ENGINE=Falcon;

Popoliamo la tabella:

insert into f values (1, 'uno');
insert into f values (2, 'due');
insert into f values (3, 'tre');
insert into f values (4, 'quattro');

Da un'altra sessione:

select * from f;
+-----+---------+
| fid | descr |
+-----+---------+
| 1 | uno |
| 2 | due |
| 3 | tre |
| 4 | quattro |
+-----+---------+
5 rows in set (0.00 sec)

Dalla prima sessione:

set autocommit=0;
update f set fid = 7 where fid = 4;

Dalla seconda sessione:

mysql> select * from f;
Empty set (0.00 sec)

Da qualche prova ulteriore, meno incomprensibile, è saltato fuori che bisogna committare anche la seconda sessione per vedere le modifiche della prima. Tutto questo in repeatable-read transaction isolation mode.
Ho provato anche in read-committed (la nostra preferita :-)) e non è un granché meglio.
Falcon fallisce inoltre il test di aggiornamento della chiave primaria:
update f set fid = fid+1;
dà una violazione di chiave primaria.

Bene. Aspettiamo ancora un po'. È meglio.

22 giugno 2007

Altro corso Oracle

La prossima settimana sarò alla Oracle di Sesto S. Giovanni per un altro corso Oracle:
Oracle Database 10g: New Features for Administrators Release 2.
Anche se lavoro già da un po' sulla 10g e ho letto qualche libro, non si finisce mai di imparare.

Chi fosse da quelle parti mi faccia sapere via e-mail.

Data pump exclude/include

Su Oracle Data Pump sono molto utili i parametri EXCLUDE e INCLUDE, mutuamente esclusivi, con cui si può specificare il tipo di oggetti che si vogliono escludere o includere nelle operazioni di export o import.
Ad esempio EXCLUDE=TABLE salverà tutto tranne le tabelle. Ma come facciamo ad escludere una tabella o un gruppo di tabelle? Usiamo la name clause, con cui specifichiamo un'espressione SQL a destra di un operatore:

EXCLUDE=TABLE:"IN ('EMP', 'DEPT')"
EXCLUDE=TABLE:" = 'EMP'"

Ora, se mettete tutto sulla command-line, Oracle si lamenta del fatto che l'espressione SQL non è corretta. Il problema è che le virgolette non arrivano all'interprete dei comandi, ma vengono interpretate dalla shell :-/

Le soluzioni sono due: una è fare l'escape delle virgolette:

EXCLUDE=TABLE:\"IN (\'EMP\', \'DEPT\')\"

Bisogna fare l'escape di tutte perché fatto delle prime, vengono interpretate le seconde.
L'altra soluzione è usare un parameter file (PARFILE='filename'), in cui gli escape ovviamente non vengono interpretati.

17 giugno 2007

Novità mysql: Falcon

Mysql ci stupisce con l'ennesimo motore di database: Falcon. Probabilmente dobbiamo questa novità all'acquisizione di InnoDB da parte di Oracle e al fatto che qualcosina che non andava molto c'era. Questo sospetto mi viene dal fatto che, come prima nuova feature, c'è un evidente MVCC. Anzi, TRUE MVCC. Viene anche evidenziata la data and index caching: ricordiamo che le "vecchie" versioni di mysql sfruttavano il buffering fatto dal sistema operativo sui device a blocchi come cache, ovvero non avevano cache di dati. Nel file di configurazione my.cnf vengono specificati nuovi parametri riguardo la memoria cache.
I dati relativi ad un singolo database (nel significato di mysql: un namespace) vengono scritti in un unico file; altri due file compongono il db: due log seriali. I metadati delle tabelle vengono scritti in un file frm, come il vecchio motore myisam.
A quanto pare i record modificati vengono tenuti in una memoria speciale chiamata record cache, mi pare di capire in maniera diversa da Oracle, che modifica direttamente i blocchi. I dati, gli indici e gli altri dati vengono scritti tutti insieme nello stesso tablespace; può avere senso in molti ambienti di produzione. C'è il log buffer, il log switch e il checkpoint, come Oracle. Interessante la presenza della compressione dei dati su disco.
Per ora non c'è ancora il backup online e il supporto per le foreign key. A quelli di mysql alcune cose non gli sono proprio simpatiche.
Ora si tratta di capire a quali feature presenti negli altri motori di mysql bisognerà rinunciare per potere avere le nuove funzionalità che Falcon offre, nonché quali cambiamenti bisognerà adottare nelle applicazioni scritte sapendo che mysql non offriva il multi-versioning e nemmeno la possibilità di fare rollback.
Io sono molto curioso, quindi ho subito approntato una macchina virtuale Ubuntu server 64 bit per provare il nuovo motore. Perché Ubuntu server? Perché la trovo minimale e molto ben fatta, a cominciare dal fatto che una volta installata manca persino l'ssh. Una configurazione ultraminimale che in ambito server non può che fare bene sia alle performance che alla sicurezza. Si ricordi poi che generalmente Ubuntu è molto ben supportata, ha sempre un'aggiornamento molto recente del kernel (anche troppo insistente), e un ambiente di sviluppo molto solido. Ho scelto la versione a 64 bit perché mysql 6 sembra intenzionato ad uscire a 64 bit come versione preferenziale.
Spero di avere presto un po' di tempo per fare prove col nuovo engine.

11 giugno 2007

Oracle a 64 bit

Nel finesettimana, per necessità lavorative, ho configurato il mio nuovo PC AMD64 con 4 GB di RAM, comprato per fare esperimenti su Oracle e Linux.
Ho tentato subito di utilizzare le versioni x86_64 sia del sistema operativo che di Oracle, ma mi sono trovato (prevedibilmente) subito in grande difficoltà, a cominciare dal riconoscimento delle periferiche. Ho provato Ubuntu 7.04, OpenSuSE 10.2, Fedora 7 e ho scaricato per ultimo SLES10, un po' disperato, ma ho lasciato perdere.
Domenica sera, dopo una giornata di relax a visitare castelli, ho avuto la giusta intuizione: ho risolto i problemi di installazione di OpenSuSE 10.2 e l'installazione di 10gR2 per x86_64 è andata a meraviglia, veramente senza problemi e velocissima. Nessun problema di package e compatibilità delle librerie, contrariamente ai problemi infiniti con le altre distribuzioni, parzialmente risolti.
Ho installato il db su ASM, a sua volta su raw devices a loro volta su logical volume LVM2. Spettacolare.
Ora il grosso della preparazione è finita, ho in cantiere altre attività sul db. Sono contento però di avere trovato la combinazione perfetta Linux/Oracle 64 bit, senza ricorrere alle distribuzioni commerciali.

29 maggio 2007

RMAN rollforward standby

Forse ne sono uscito. Per colpa di qualche script scritto male si sono persi dei redo log archiviati dal database RAC in produzione, quindi lo standby database non poteva più andare avanti.
Il concetto è questo: si usa RMAN per fare il rollforward dei blocchi dei datafile dello standby, che essendo fisico sono uguali a quelli originali.
Per fare ciò bisogna procurarsi un backup incrementale per lo standby:

SQL> SELECT CURRENT_SCN FROM V$DATABASE;

RMAN> BACKUP INCREMENTAL FROM SCN <scn dello stdby> DATABASE FORMAT '/tmp/ForStandby_%U' tag 'FOR STANDBY';

Portare poi i file prodotti al cospetto dello standby, portandoli a conoscenza del suo RMAN:

RMAN> CATALOG START WITH '/tmp/ForStandby_';

Io ho utilizzato un catalogo sul db principale e il control file sullo standby per evitare problemi: i due db hanno lo stesso ID!
Ora gli diciamo di fare il recover senza redo!:

RMAN> RECOVER DATABASE NOREDO;

Ora il database dovrebbe essere pronto:

SQL> ALTER DATABASE RECOVER MANAGED STANDBY DATABASE USING CURRENT LOGFILE DISCONNECT;

Peccato che, nel mio caso, il control file dello standby è rimasto all'SCN originale, quindi ho dovuto ricrearlo con uno snapshot di RMAN sul principale:

SQL> ALTER DATABASE CREATE STANDBY CONTROLFILE AS '...';

Portiamo il control file appena creato sullo standby e facciamo partire l'ultimo recover; dovrebbe funzionare.

22 maggio 2007

ASM su... USB!

Oggi, durante la lezione al corso Oracle di amministrazione RAC 10gR2, improvvisamente il docente tira fuori due strani oggetti blu, con due fili che uscivano da un'estremità. Dopo un paio di secondi di silenzio interrogativo, si sono rivelati una coppia di hub USB passivi con 8 "chiavette" USB. Stavamo parlando di ASM e quindi alcuni hanno capito al volo: le 8 chiavette sono state utilizzate per simulare 8 dischi reali!
Un'idea fantastica e spettacolare: mi immagino gli 8 led che lampeggiano in modo psichedelico durante l'utilizzo con ASM! Deve essere anche molto istruttivo e fa capire molto chiaramente come funziona ASM e un volume manager generico, volendo.
Complimenti al docente! Un grande (d'altronde è laureato in fisica come me :-)

19 maggio 2007

DBA Oracle a tempo pieno

Il silenzio relativo degli ultimi mesi ha una spiegazione: da lunedì scorso ho cominciato a lavorare come DBA Oracle/system engineer per un'azienda di Milano.
Per me è un grande cambiamento, ma ho trovato un ambiente molto professionale e colleghi molto preparati; tutto ciò è per me di grande aiuto.
Ora ho a che vedere con tecnologie che ho utilizzato solo per esperimenti personali: Real Application Clusters e Standby database. Tutto veramente intrigante ;-)
Proprio ieri ho recuperato un database in standby che non voleva saperne di ripartire per un danno al tablespace di system (grande scelta per un file corrotto...). Ho fatto un recover di 2 ore e 40 minuti e poi il db è tornato all'antico splendore.
Beh, per la prima settimana è una piccola grande soddisfazione.
Cercherò di essere più presente con il blog; dovrei avere anche molto materiale sotto mano per nuove idee ;-)

Per tutta la prossima settimana sarò a un corso nella sede Oracle a Sesto S. Giovanni. Chi fosse da quelle parti mi può avvertire con una mail.

01 aprile 2007

Ci sono ancora - Verity

Ciao a tutti! È da tempo che non scrivo, ma chi mi segue sa che sono stato in Cile e ho un periodo di lavoro piuttosto denso.
Nel frattempo ho cominciato a studiarmi, stavolta per lavoro, il motore di ricerca Verity. Lo so, è un po' off-topic rispetto a questo blog, ma ritengo di doverlo riportare ad uso di tutti quelli che non hanno un sito transazionale, ma solo di ricerca e indicizzazione di contenuti.
Il prodotto ora ha cambiato nome (districatevi voi nelle sigle del marketing sul sito, io ci rinuncio), io riporto comunque qualche funzionalità della versione 5.5.
La cosa secondo me più notevole è l'architettura, ovvero lo stack tecnologico di un'installazione Verity: in cima ci sono i broker, una sorta di dispatcher, poi i server Verity, infine eventuali sorgenti esterne di dati, che possono anche essere indicizzate continuamente. La forza di questa architettura sta nel fatto che i broker possono sia bilanciare il carico delle query che garantire il failover, e che i server possono ospitare anche collezioni condivise, suddividendosi il carico.
Maggiori informazioni più avanti!

12 febbraio 2007

Nuove tecnologie Oracle

È un bel po' che non scrivo, ma ultimamente ho molto da fare e durerà ancora per un po'.
Intanto riporto qualcosa dalla newsletter OTN, sempre molto interessante:

30 dicembre 2006

Opensolaris


I Boot OpenSolaris
Alcune indiscrezioni sull'uscita del filesystem ZFS nella prossima versione di Mac OS X mi hanno spinto a interessarmi, ancora una volta, a Opensolaris, aiutato anche da qualche suggerimento di tuning di Oracle dell'ultimo esame sostenuto.
Solaris ha una caratteristica unica, ovvero la ISM (Intimate Shared Memory), che permette ai processi di condividere l'area di memoria che contiene la mappatura da indirizzi di memoria virtuali a indirizzi reali. Beh Solaris ha anche ZFS! Supporta inoltre le CPU Intel a 32 e 64 bit, oltre ai RISC di casa Sun.
Bene, ora trovo un server adeguato e poi sotto con le installazioni. Mi sembrerà di ritornare ai laboratori dell'università, ma allora utilizzavo software di calcolo per astrofisica sulle Sparcstation 4 :-)

Rails, ORM e RDMBS

Lo studio di Rails prosegue, e finalmente sono arrivato ai punti focali per l'importanza ai fini di un utilizzo con un database relazionale. È presente la possibilità di personalizzare l'accesso alle tabelle, ma tutto avviene a livello di namespace, concettualmente non cambia nulla: Rails ha bisogno di uno schema in cui le tabelle sono correlate da chiavi primarie surrogate autoincrementanti, l'unica cosa che si può cambiare è il nome delle colonne. Le relazioni tra tabelle 1:1, 1:n, n:n devono essere ripetute nella definizione degli oggetti/modelli ActiveRecord, ovvero la parte ORM (Object Relational Mapping) di Rails, che permette di utilizzare gli oggetti del linguaggio (Ruby) come se fossero dei record di una tabella nel database. Questa ripetizione non va a vantaggio della semplicità e mantenibilità del codice, in quanto costringe a ripetere nel codice Ruby le affermazioni che sono già state fatte nel database.
Devo dire che l'architettura di Rails e l'eleganza di Ruby sono affascinanti: tutto è stato pensato per uno sviluppo di applicazioni web e nulla è stato lasciato al caso.
Vedremo più avanti se ci saranno altre sorprese.

18 dicembre 2006

Certificato OCP 9i

Proprio stamattina ho passato l'ultimo esame per la certificazione Oracle OCP 9i! Sono troppo contento! Ora spero che mi mandino almeno una maglietta :-)
Stavolta c'era un po' di gente: eravamo i 4, ma la cosa sorprendente è che 2 non hanno passato l'esame, uno dei quali faceva il mio stesso test (1Z0-033).
In futuro potrebbe esserci - chissà - un upgrade alla 10g oppure qualche strana "specializzazione" (tipo Linux).
Ora mi godo un po' di ferie, ma il blog rimane attivo come sempre.

14 dicembre 2006

Le basi di tutto

Seguo da molto tempo il newsgroup it.comp.software.database. Con periodicità regolare vengono postate domande la cui risposta dovrebbe essere già chiara da tempo, specie sul design del proprio modello dei dati.
Puntualmente mi ricordo di avere letto da qualche parte esempi in merito di una tesi o un'altra, ma la maggior parte delle volte dovrei fare riferimento a uno dei capitoli più straordinari che abbia mai letto: il capitolo 1 di "Effective Oracle By Design" di Thomas Kyte.
Scaricatelo, stampatelo, leggetelo, fotocopiate ingrandite le frasi migliori e appendetele al muro.

07 dicembre 2006

Ruby on Rails e Oracle

Oracle Application Express (XE) è la piattaforma di diffusione di Oracle presso il grande pubblico di sviluppatori web interessati al framework XE, una volta chiamato "HTMLDB".
Un ottimo effetto collaterale del progetto è che è possibile utilizzare Oracle XE come database solamente, senza tanti problemi di installazione né di licenze.
Un approccio abbastanza naturale potrebbe essere l'utilizzo di Ruby on Rails come linguaggio e framework per lo sviluppo di applicazioni web basate su Oracle.
Oracle stessa non si fa attendere e pubblica un interessante articolo per iniziare a sviluppare e a portare le proprie applicazioni sulla propria piattaforma. Instant client permette una rapida e facile installazione.

Personalmente mi sto studiando il manuale ufficiale di Ruby on Rails. Il framework è molto elegante e semplice da utilizzare, anche se richiede una certa confidenza con le successioni di eventi tipiche di un'applicazione web. Il problema più grande, a mio avviso, è l'utilizzo estensivo di chiavi primarie con id autoincrementanti per le relazioni fra tabelle, di facile amministrazione per il framwork, ma di difficile e illogica manutenzione per gli esseri umani. Mi riservo ulteriori giudizi quando arriverò alla fine del libro; spero di trovare il modo (semplice) di superare l'impossibilità apparente di usare chiavi primarie reali anche composite.

30 ottobre 2006

Densità di bug

In questi giorni si è parlato molto del fatto che Oracle supporterà Red Hat Linux come piattaforma enterprise. In un post di un blog su mysql dei giorni scorsi, che ha riportato la notizia, l'autore non perde l'occasione per "denigrare" i database commerciali citando un articolo di ZDnews. In questo articolo si afferma che il codice sorgente commerciale ha tra 1 e 7 bug ogni 1000 linee, mentre mysql 1 ogni 4000 linee. Non viene detto di quali bug si tratti, anche se sembra che riguardino la sicurezza.
Chissà se la sicurezza contro gli attacchi informatici è l'argomento di discussione principale tra DBA e sviluppatori :-P
O è forse l'affidabilità e l'integrità dei dati?

17 ottobre 2006

mysql enterprise

Ma secondo voi basta aggiungere la parolina magica "enterprise" per rendere un prodotto lo stato dell'arte del suo settore?

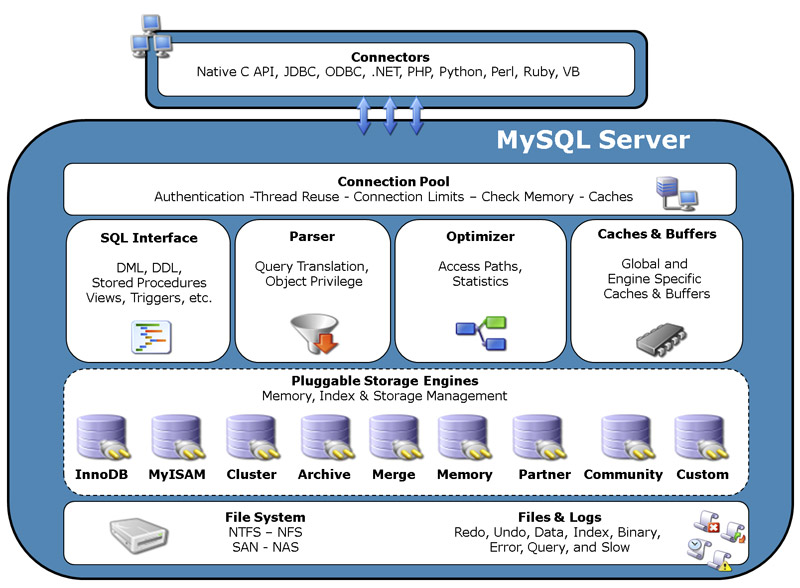
Qual è il vantaggio reale dell'architettura Pluggable Storage Engine Architecture? Per me è evidente che l'esistenza di più di una architettura implica necessariamente vantaggi e svantaggi a sceglierne una in particolare, altrimenti ce ne sarebbe una sola: la migliore.

Viene detto che i vari storage engine hanno limitazioni? Faccio un esempio che da solo dovrebbe bastare: le transazioni sono disponibili solo per il motore InnoDB, o comunque non certo per il motore MyISAM, che dovrebbe essere quello con la maggiore quantità di feature.

Se per tutti i prodotti commerciali si conoscono evidenti esempi di feature nate per esclusive esigenze di marketing, che cosa si può dire dei proclami inseriti nella pagina di presentazione?

È vero, mysql ha tradizionalmente la sua giusta collocazione in molti ambienti, potrei dire non molto impegnativi dal punto di vista strutturale. Non va dimenticato che l'aggiunta di caratteristiche che la maggior parte degli altri database avevano già per design iniziale inficia sicuramente anche le caratteristiche di velocità.

Di pubblicità ce n'è già abbastanza in TV. Per chi la guarda.

01 ottobre 2006

Berkeley DB e MVCC

L'acquisizione da parte di Oracle di Berkeley DB ha mostrato le prime conseguenze: la nuova release 4.5 di BDB ha come più evidente novità la presenza dell'MVCC, ovvero del Multi-Version Concurrency Control, tipico di Oracle.
Recentemente è apparso su it.comp.software.database un interessante thread sull'MVCC, con indicazione di un interessante documento di IBM (grazie a "The man with two watches") sul multi-versioning, che ne descrive i limiti (facendo anche pubblicità a DB2, per la verità).
Ora mi sono parzialmente liberato da pesanti impegni, quindi sto mettendo assieme un po' di materiale per discutere sull'MVCC e altro. Stay tuned!

17 settembre 2006

Logical standby database

Scusate il lungo silenzio dal primo di agosto, ma non ho avuto novità significative. Ho provato l'installazione di Enterprise Manager su una macchina singola, ma mi sono imbattuto in difficoltà troppo grandi da essere affrontate su un semplice PC. Purtroppo ci vuole soprattutto molta RAM; volendo ci si può appoggiare a VMware per tutte le necessità in fatto di numero di server, ma ciò comporta avere moltissima memoria fisica a disposizione.
Oggi segnalo un interessante articolo di Databasejournal sui logical standby database su architettura Oracle. La soluzione ricorda molto quella di mysql, basata sulla replica dei log. Con quest'ultima ho avuto molto a che fare per questioni lavorative (versione 4.0.15), ma non mi sembra un granché affidabile: capita infatti spesso che mysql non capisca ciò che lui stesso scrive nei log, e in più la terminazione di processi lato master porta ad inconsistenze lato slave.

01 agosto 2006

Oracle 10gR2 RAC su SLES10 su VMware

Ho finalmente terminato di scrivere l'articolo sull'installazione di un cluster Oracle 10gR2 RAC su SLES10, tutto sotto VMware.
Potrebbero esserci mancanze o imprecisioni, ma il lavoro richiede un tempo molto lungo, sia per le prove che per la composizione HTML. Dovrei infatti affidarmi ad un content-management tipo Joomla! come fa ad esempio Howard Rogers, da cui ho preso l'ispirazione per iniziare le mie prove di installazione.
Sono riuscito sia a installare RAC in contemporanea su due server, sia ad aggiungere una macchina al cluster RAC già attivo, arrivando a un totale di 3 macchine, tutte sullo stesso server ospite con il grande VMware, dove tra parentesi sta girando un server di test (reale) 8.1.7 :-). Devo dire che le prestazioni sono ottime con due server, mentre dopo l'aggiunta del terzo il sistema cominciava globalmente a soffrire un po', ma bisogna contare il carico totale piuttosto elevato.
Il cluster è basato su OCFS2; devo studiare la possibilità di creare un cluster con ASM, ma se ne parlerà più avanti.

Mi aspetto un bel feedback, quindi sotto coi commenti e le mail!

28 luglio 2006

Aggiunta la terza istanza RAC

Sono riuscito ad aggiungere la terza istanza al mio nuovo RAC Oracle 10gR2 sperimentale.
Spettacolare.
L'installazione è meno manuale rispetto a quello che pensassi.
Ho molte idee, screenshot e appunti da riorganizzare per l'articolo. Chissà come sarà il tempo questo finesettimana. Ci vuole tempo a scrivere!

Ho testato quindi le seguenti cose:
1) Installazione su due nodi in contemporanea
2) Aggiunta di un'istanza/macchina a un RAC esistente

system@hillrac> select instance_number, instance_name, version, status
2 from gv$instance;

INSTANCE_NUMBER INSTANCE_NAME VERSION STATUS
--------------- ---------------- ----------------- ------------
1 hillrac1 10.2.0.1.0 OPEN
2 hillrac2 10.2.0.1.0 OPEN
3 hillrac3 10.2.0.1.0 OPEN

25 luglio 2006

Oracle 10gR2 su SLES10

Ho finalmente completato l'installazione di Oracle 10gR2 Real Application Cluster sulla nuovissima SLES10 (SuSE Linux Enterprise Server 10) utilizzando VMWare Server.
Come al solito la procedura è stata veramente difficile e piena di ostacoli, dovuti soprattutto alle piccole-grandi incompatibilità del sistema con Oracle 10gR2.
Ora il cluster sta muovendo i suoi primi passi, mi manca l'aggiunta della terza istanza, ma ci vorrà ancora un po' di tempo.
Inoltre probabilmente dovrò rifare tutto per riprendere gli screenshot che non ho registrato in presa diretta; infatti ho in mente di pubblicare un lungo articolo sul tema dell'installazione. Rimanete sintonizzati!

16 luglio 2006

Ancora su Oracle e RAID

Segnalo, sempre dal sito baarf, un'interessantissimo documento, ormai un po' datato ma con un taglio scientifico, di Cary Millsap del 1996 sui VLDB (Very Large Databases), in cui viene spiegato nel dettaglio, tra l'altro, la relazione tra lo storage RAID e le esigenze di un database, nello specifico un grande database; secondo me è molto utile per prendere le scelte migliori per quanto riguarda la configurazione dei propri server.
Tutto ciò mi ha dato lo spunto per iniziare la lettura del libro che avevo ordinato tempo fa ma che non avevo mai avuto occasione di leggere (ho studiato :-)), Optimizing Oracle Performance, anche se il tuning è l'ultimo aspetto da considerare nella propria formazione.

13 luglio 2006

Oracle e storage SAME

Da un hot topic di asktom.oracle.com sullo storage, sono arrivato al sito http://www.baarf.com/, che si schiera apertamente contro ogni tipo di RAID.
Molto interessanti risultano le letture di Cary Millsap sul RAID5, e soprattutto quelle di Juan Loaiza di Oracle su SAME, per cui è disponibile anche una presentazione PPT.
SAME è l'acronimo di Stripe And Mirror Everything; nei documenti si afferma che la metodologia SAME, calcoli alla mano, sarebbe valida per qualsiasi tipo di dato Oracle (OLTP, DW, redo, ecc.), eliminando la necessità di configurare dischi diversi per scopi diversi. Molto interessante la parte dei redo-log e RAID.
I punti fondamentali sono i seguenti:

  1. Usare un volume manager per lo striping dei dati su tutti i dischi disponibili

  2. Usare dischi in mirror

  3. Usare la parte più esterna dei dischi per i dati a cui si accede più frequentemente

  4. Suddividere i dati per partizione, non per disco


Quello che posso dire io è che, avendo avuto a che fare con diversi sistemi RAID, anche nel loro caso sembra che siano stati fatti per utilizzare tutti i dischi disponibili in un solo volume per il migliore compromesso tra spazio, prestazioni e facilità di manutenzione.

10 luglio 2006

Tipi tabelle

Segnalo un articolo di Steve Callan a proposito dei tipi di tabelle in un database relazionale.
L'articolo parla di tipi di tabelle nel senso della loro funzione; ad esempio tabelle di staging, operazionali, di archivio. Ovviamente tale classificazione ha come scopo l'identificazione delle funzionalità delle tabelle all'interno di un data model.
(da Database Journal)

30 giugno 2006

Mi sono certificato!


Da oggi sono certificato Oracle DBA 9i di livello OCA, ovvero il primo livello di certificazione DBA disponibile.
Sono troppo felice!
Gli esami sono stati difficili, molto più di quanto mi aspettassi.
Ora inizia la seconda fase, ancora più difficile, che richiederà mesi di studio: la seconda parte dell'amministrazione del database (backup and recovery) e la fase finale di performance tuning, per cui avrò l'aiuto del testo di Tom Kyte :-)

29 giugno 2006

Database e filesystem

Sembra che WinFS, il nuovo filesystem dell'annunciato Windows Vista, non venga più inserito nel nuovo sistema operativo della Microsoft (da Zeus News).
A quanto dice Quentin Clark, del WinFS Team, una parte del progetto riguarda l'integrazione di dati non strutturati in un database relazionale. Ritengo che sia molto istruttivo considerare questa profonda relazione tra filesystem e database, un rapporto che a volte è più sbilanciato verso l'uno o l'altro, come ad esempio mysql.
Lo scopo finale di WinFS è quello di ridurre o annullare il lavoro di amministrazione del database nel caso di dati non strutturati, caratteristica che dovrebbe essere integrata nella prossima versione di SQLServer.
La relazione database-filesystem porta però a pensare a quanto lo storage e la gestione delle transazioni dei database vengano sviluppate secondo linee di pensiero parallele (es. LVM e datafiles, journal e redo-log, indici dei file e indici delle tabelle).

23 giugno 2006

The daily WTF (what the...)

Segnalo il divertente blog The daily WTF, che raccoglie le stranezze (a dir poco) che gli autori incontrano nell'information technology, ma non solo.
Divertentissimi i racconti del Report Misterioso, il Black-box Blackboxing, Pointless. Chi lavora su queste cose si sarà sicuramente trovato in molte situazioni simili.

15 giugno 2006

Matematica di Oracle

Segnalo un ottimo articolo di Database Joournal sul calcolo delle funzioni trascendenti in Oracle e, più in generale, per i computer.
Interessante il fatto che le funzioni ln2a e ln2b sono state scritte in PL/SQL, con una performance comparabile a quella delle funzioni native.

17 maggio 2006

SQL Server 2005

Ieri sono andato alla prima giornata della introduzione tecnica a Microsoft SQL Server 2005, dedicata all'amministrazione del sistema.
Sono rimasto piacevolmente sorpreso della sobrietà e serietà dell'evento, tutt'altro che dedicato a pubblicità e marketing; anzi, alla fine si è praticamente trattato di un corso in piena regola, molto denso di contenuti ed esempi pratici.
Un plauso a Gianluca Hotz, che ha tentato l'impossibile per condensare tutti i concetti dalle 9:30 del mattino alle 18:00 di sera con un'ora di pausa totale per caffé e cibo!
Peccato non poter presenziare anche alle altre due giornate, si preannunciavano ricche di contenuti.

Ecco i principali argomenti interessanti che ho rilevato:

  • Ricerca full-text con possibilità di scrivere plug-in personalizzati, con comandi DDL per accedere al catalogo invece di stored procedures; supporto per più lingue anche sulla stessa colonna; ft indexing di dati XML

  • Service Broker è un'estensione di T-SQL per implementare le code asincrone di messaggi, che vengono usate per le funzioni più disparate del DB.

  • Supporto SOAP per i web-service direttamente nel DB

  • Catalogo molto arricchito e tabelle di sistema inaccessibili a chiunque se non tramite le viste di sistema, non più aggiornabili :-) Il catalogo contiene inoltre una serie di viste che permettono di avere le statistiche di base prese durante il funzionamento.

  • CLR: è possibile programmare il DB anche in C#, .NET, VB, C, C++ con vari livelli di sicurezza

  • Nuovi tipi di dato serie varchar senza più limitazioni a 4000 o 8000 byte

  • Caricamento ed esportazione dei dati in XML

  • Gestione dei punti di entrata nel DB come endpoints, quindi maggiore controllo e sicurezza (tutto è disabilitato di default, a quanto pare)

  • SQL Server Management Studio è spettacolare, l'ho visto utilizzare per vari compiti, molto semplice e immediato ed è un'applicazione MS nativa.


Da approfondire con l'Express edition, gratuita, da provare insieme a SSMS.

02 maggio 2006

AJAX, RAC e PHP

Dalla newsletter OTN:

28 aprile 2006

View e order by

In un libro su Oracle che sto leggendo ora ho trovato varie versioni della questione se sia possibile creare una view con una query contenente la clausola "ORDER BY".
Nel libro (di cui vi dirò in futuro) ho trovato prima una versione che permetteva questa sintassi:

create or replace view myview as
(select * from emp)
order by ename;


Alla fine diceva che era possibile anche omettere le parentesi:

create or replace view myview as
select * from emp
order by ename;


A quanto pare nel passato ciò era impossibile, a quanto risulta da questa risposta di Tom Kyte su un newsgroup, ma oggi lo è.
Tom Kyte, nel post citato, spiega anche chiaramente perché l'ordinamento nelle view è fondamentalmente inutile; infatti nella teoria relazionale non se ne fa menzione, e tutte le relazioni vengono trattate come insiemi, in cui l'ordinamento non è rilevante, ma riguarda solo una rappresentazione dei dati.

18 aprile 2006

Oracle verso Linux e l'open-source

Su arstechnica.com è apparso un servizio secondo il quale Oracle sarebbe interessata ad entrare nel mercato delle distribuzioni Linux.
Ellison si è dichiarato interessato a Novell; la collaborazione tra Oracle e Novell recentemente si è rafforzata con la soluzione Accelerator per Oracle 10g.
Molte delle funzioni del sistema operativo sono ora incorporate in Oracle, come ad esempio la gestione dei dati su disco con ASM e 10g; Oracle avrebbe la possiblità di fornire una soluzione completa, nonch´ di confezionare su misura una distribuzione Linux e il suo kernel.

Oracle 9iR2 (9.2.0.4.0) su Dapper Drake!

Ieri, approfittando della festa E del brutto tempo, ho provato ad installare Oracle 9iR2 9.2.0.4.0 su Ubuntu 6 Dapper Drake in prerelease.
Interessante la difficoltà a far partire la JVM per colpa delle librerie libstdc++ troppo aggiornate: ho dovuto installare la prima versione disponibile da APT.
Alla fine la parte più comica è stato il segmentation fault proprio all'inizio della configurazione del DB, dopo l'ultima fase dell'installazione; meno male che avevo fatto creare come da buona usanza gli script di creazione del DB, quindi con qualche tentativo manuale à andato tutto a posto.
Ora mancano le configurazioni dei nomi di rete e del listener.

09 aprile 2006

Concatenazione in mysql

Ho recentemente avuto a che fare con una query in mysql dove le condizioni di join erano espresse nel seguente modo (con ansi-mode attivato):

[...] on
a.col = 'cost' || b.col

Nonostante b.col e a.col fossero indicizzate, l'explain della query portava l'uguaglianza a considerare TUTTE le righe della tabella b, circa 2 milioni.
Incredibilmente la versione seguente funzionava a dovere:

[...] on
a.col = concat('cost', b.col)

smentendo quindi il manuale, dove si afferma che le due versioni sono la stessa cosa (nella pagina: PIPES_AS_CONCAT).

21 marzo 2006

Kernel Linux e OCFS2

Durante la mia installazione RAC 10g su Ubuntu 5 ho incontrato diverse difficoltà con OCFS2, che sembra andare ma alla fine blocca l'installazione di Clusterware; in più segnala come utilizzati solo dalle rispettive macchine i dischi condivisi, nonostante non vengano evidenziati errori.
A quanto pare la soluzione definitiva arriva dai sorgenti del kernel Linux stesso: la nuova versione 2.6.16 incorpora OCFS2 nativamente. Una bella descrizione di OCFS si può trovare nelle pagine di LWN.
Sarà quindi meglio per me attendere Ubuntu "Dapper Drake" prima di poter proseguire nell'installazione di RAC.

20 marzo 2006

Torno a studiare

Ieri ho deciso di iniziare a studiare per la certificazione Oracle.
Era da tempo che ci pensavo, e visto che ho all'attivo un corso di DBA Oracle fundamentals I, ho deciso per il percorso 9i.
Su Amazon ho deciso per il kit della Oracle Press, OCP Oracle9i DBA Certification Boxed Set, anche se ho letto opinioni contrastanti sui newsgroup e nei commenti di Amazon.
Intanto sono arrivato a più di 1/3 di Oracle Concepts, documentazione ufficiale. Un libro assolutamente fondamentale, che consiglio a chiunque.

10 marzo 2006

Novità techblast Oracle

Dalla newsletter OTN due importanti novità:

  • Project Raptor è diventato Oracle SQL Developer, è arrivato alla versione 3 Early Adopter, liberamente scaricabile come sempre.

  • Segnalo un bell'articolo sulle connessioni persistenti di PHP con Oracle, dal PHP Cookbook

09 marzo 2006

Oracle 10gR2 RAC e Ubuntu

Ho sotto mano un server di test con 2 GB di RAM, quindi ho deciso di provare a installare Oracle 10gR2 RAC su Ubuntu Linux server usando VMware server, che a quanto pare è diventato gratuito.
Sono a metà dell'installazione, non so se arriverò ad un sistema funzionante, ma le premesse ci sono tutte.
Ubuntu mi sorprende sempre più, si dimostra un sistema operativo completissimo e aggiornatissimo.
Per i dettagli, che sono abbondanti, ci vorrà tempo.
Intanto potete leggervi gli interessantissimi articoli di Tarry Singh.